
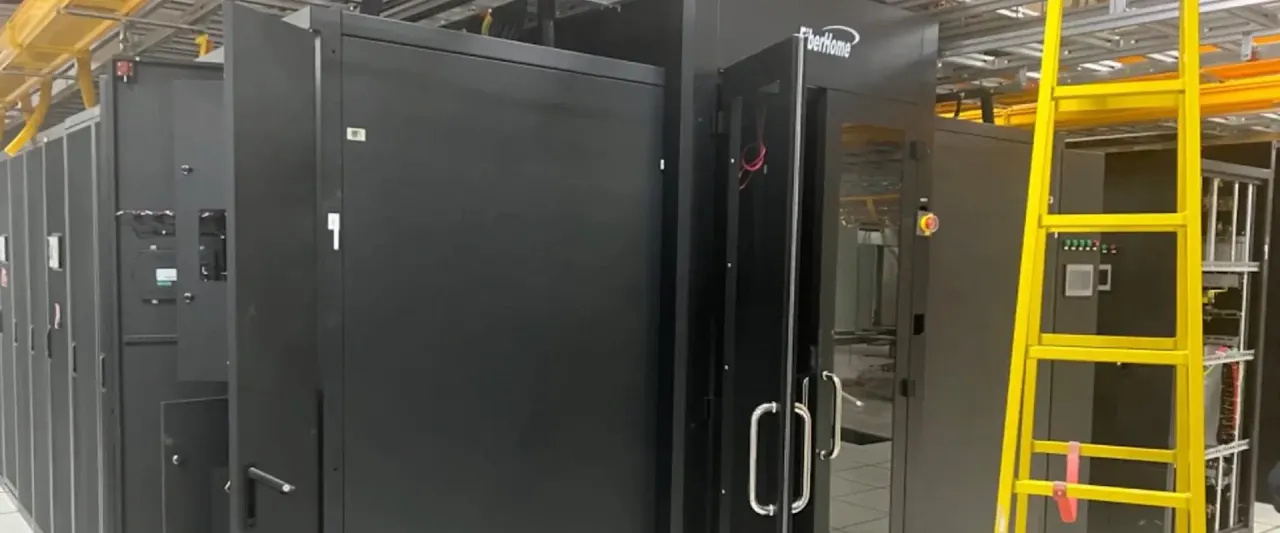
把算力建在产业旁边
从园区规划、模块化机房到 GPU 集群与持续运维,润六尺用一支团队承接智算中心从开工到稳定运行的每一段。
50天首期交付周期
4地区域算力节点
24小时持续运维目标
把机房,变成可交付的算力
训练和推理需要的不只是服务器。供配电、液冷、高速互联、调度与安全边界必须一起设计,才能在业务峰值到来时保持稳定。
- 按训练或推理负载确定机柜功率、网络拓扑和集群形态。
- 把建设、设备上架、联调与运维放在同一套交付计划里。
- 用可监控、可扩容、可追责的方式承接长期运行。
先算清业务,再决定机房
从模型规模、并发峰值和部署边界出发,确定功率、制冷、网络与扩容空间。
把现场施工变成可控节奏
以模块机房、标准化上架和分区联调缩短交付周期,减少多团队衔接中的空档。
GPU 之间没有断点
围绕集群训练与高吞吐推理设计存储、交换和网络路径,让资源真正组成一个算力池。
上线只是稳定运行的开始
用能效、资源利用率、告警与容量视图持续优化,让基础设施经得住真实业务检验。
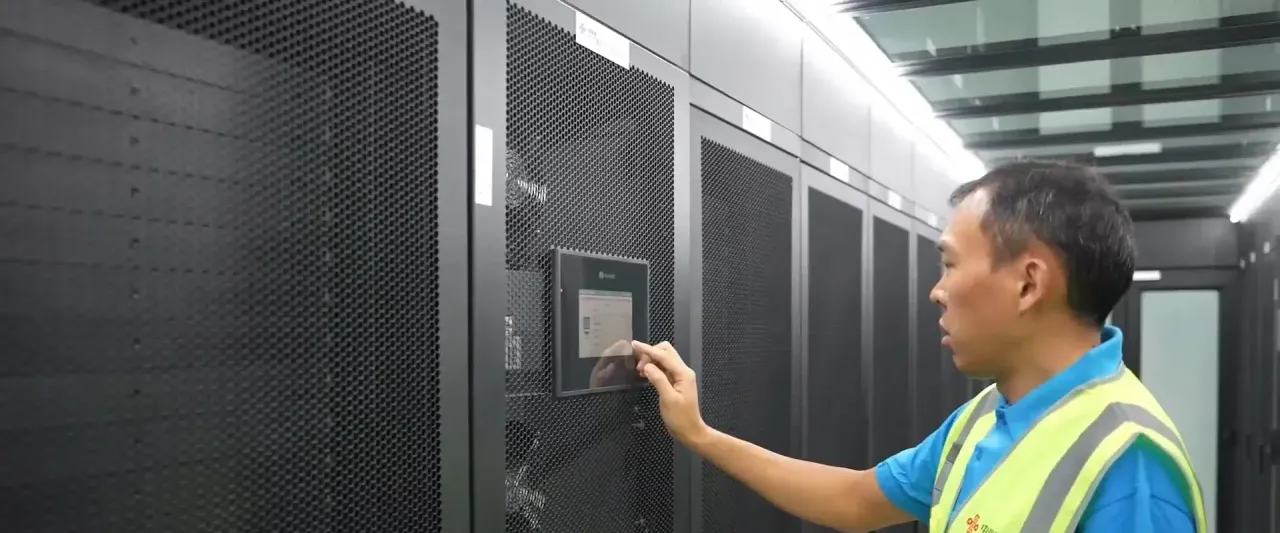
每一段路,都在真实项目里走过
芜湖首期项目围绕算力基础设施建设、GPU 集群部署、网络与运维体系展开,形成从方案设计到交付运营的完整工程闭环。
基础设施的价值,要在持续运行中体现。
- “东数西算”芜湖集群项目实践
- 从机房改造到集群交付的一体化能力
- 服务高校、科研机构、运营商及产业客户
从一个地址,到一张可运营的算力网
项目按顺序推进。每个阶段都有明确交付物,也都能回看和验收。
- 01
选址与负载评估
确认园区条件、业务负载、功率边界和交付目标。
- 02
方案与施工
完成机房、供配电、制冷、网络与设备方案。
- 03
集群联调
完成设备上架、网络验证、压力测试和模型环境部署。
- 04
交付与运营
建立监控、扩容、故障响应与持续优化机制。